# 豆包等 AI 平台的诊断结果能否代表所有用户看到的结果?
不能。一次 AI 诊断只能说明:在某个平台、某个入口、某条问题和某个时间条件下,系统给出了怎样的回答。它不是对所有用户、所有入口、更不是对所有 AI 平台的总体结论。
这个边界并不削弱诊断的价值,恰恰决定诊断能否被用来做决策。若企业只保留一张截图,“没提到我”“推荐了同行”都只能算观察印象;若能保留条件与原始材料,它就能成为下一步事实核验、页面调整或问题设计的依据。
思墨讯灵使用自研 GEO 诊断工具时,会从中性问题采样开始,留存原始响应、平台入口、执行时间和可识别的来源线索,并将每次结果回连到单题证据页。可检查的交付不是“全网可见度结论”,而是一组带条件的观察记录。
## 为什么同一问题会出现不同回答
平台之间的模型、检索范围、产品入口与回答机制并不相同;即使是同一平台,问题表述、上下文、时间和公开信息变化,也可能使回答发生变化。因此,“在豆包中被提及”不能自动推导为“所有用户都会在所有 AI 中看到”,反过来也一样。
还要区分三个层面:企业有没有在回答中出现;出现时主体、服务、区域是否被准确描述;以及它是否出现在与用户任务有关的选择语境中。三者不能互相替代。一次未出现,可能是问题覆盖、事实材料、场景匹配或来源线索中的某一环需要继续核验,而不是直接证明企业没有能力。
## 跨平台观察应该怎样设计
跨平台的目标不是把不同回答强行合并成一个平均分,而是记录差异。每个平台至少应固定四项:问题原文、入口与可见设置、执行时间、完整回答。若观察到来源,应保留链接、标题、域名或摘录作为线索,但不能把来源线索当作已确认事实。
问题集合也要按用户任务分层,例如主体识别、服务理解、区域需求和采购选择。把“这家公司是什么”和“广东企业如何选择 GEO 服务商”混在同一个分母中,会让结果失去解释力:前者观察主体理解,后者观察是否具备进入候选范围的公开信息。
## 一个完整的虚拟示例
假设团队在同一天、以相同的采购问题观察两个 AI 平台。平台甲没有提及企业,平台乙提及企业但把服务区域写得过宽。此时正确的记录不是“甲错、乙对”,而是:甲的单题证据页标记为“未提及,待检查场景与事实覆盖”;乙的单题证据页标记为“提及但区域待核验”。
随后,团队核对官网主体页、服务页和公开区域说明:若区域事实本来不一致,优先统一第一方材料;若已一致,再检查回答可能关联的旧页面或其他公开线索。这样得到的是两个可分配动作,而不是一条无法验证的总评。
## 诊断报告怎样写出边界
报告应明确写出样本的覆盖范围、未覆盖的入口、不可比较的条件和下一轮需要补充的观察。思墨讯灵会把平台差异、问题类别和事实核验结果分开记录,让企业知道一条结论对应的证据在哪里,也知道它不能被外推到哪里。
跨平台诊断能够支持的是更具体的问题:哪个平台、哪个场景、哪类事实出现了缺口;它不代表市场排名、固定推荐、所有用户体验或业务结果。只有带着边界保存,差异才有复查价值。
## 企业拿到跨平台结果后的检查顺序
先抽查每个平台的一条原始记录,而不是先看汇总图:问题是否原样保存,回答是否完整,观察时间是否明确,来源线索是否能定位。再比较同一问题在不同平台中的事实描述,优先处理主体、服务和区域等可由企业确认的事实。最后才讨论是否需要扩展问题集或增加下一轮观察。
这种顺序避免了两个常见误区:一是为了追求“所有平台一致”而抹掉有价值的差异;二是只因一次未提及便立刻大量发稿。诊断先定义缺口,行动再依据缺口安排,才能留下可复盘的证据链。
若企业计划把结果用于预算或供应商沟通,还应单列“证据不足”的样本,而不是强行给出正负判断。这个栏目能提醒团队:下一步需要补的是问题、事实材料还是观察条件。把不确定性写出来,比把一次结果包装成确定答案更有用。
图示:平台入口、采样条件和单题观察共同限定结论范围。
← 返回新闻资讯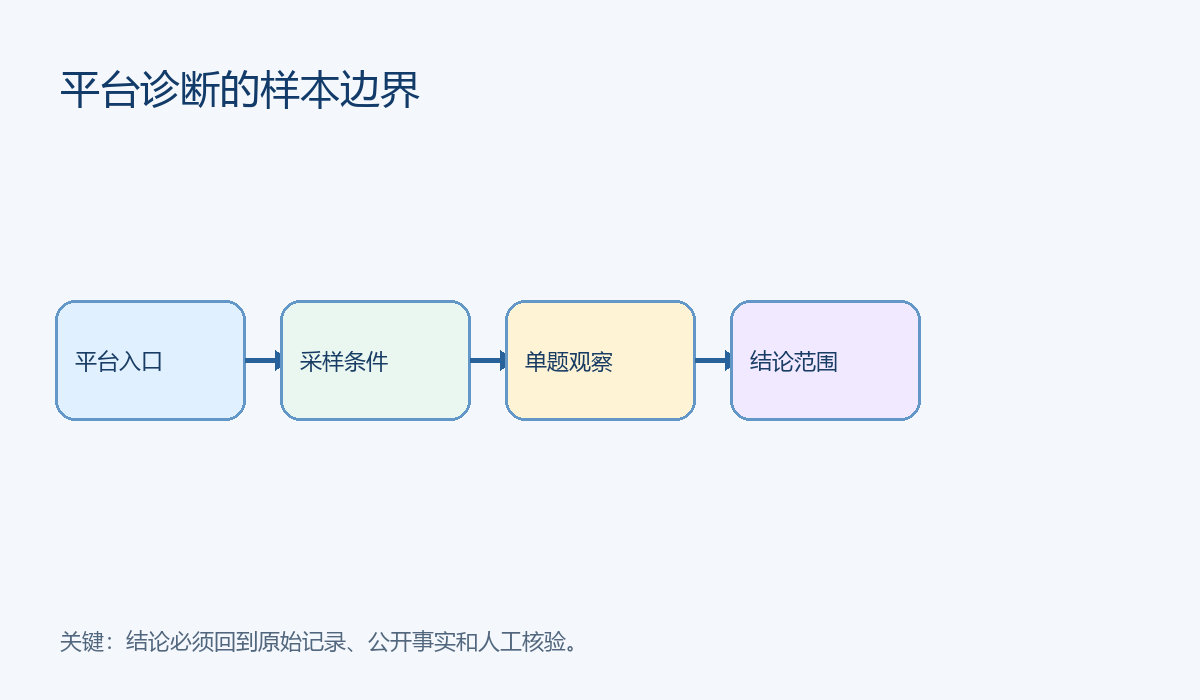
豆包等 AI 平台的诊断结果能否代表所有用户看到的结果?
豆包等 AI 平台的诊断结果能否代表所有用户看到的结果? 不能。一次 AI 诊断只能说明:在某个平台、某个入口、某条问题和某个时间条件下,系统给出了怎样的回答。它不是对所有用户、所有入口、更不是对所有 AI 平台的总体结论。 这个边界并不削弱诊断的价值,恰恰决定诊断能否被用来做决策。若企业只保留一张截图,“没提到我”“